دست نوشته ها

مسیر تبدیل لاگ‌های پراکنده سامانه به هوش عملیاتی و تصمیم‌گیری راهبردی در Process Mining

, , ,
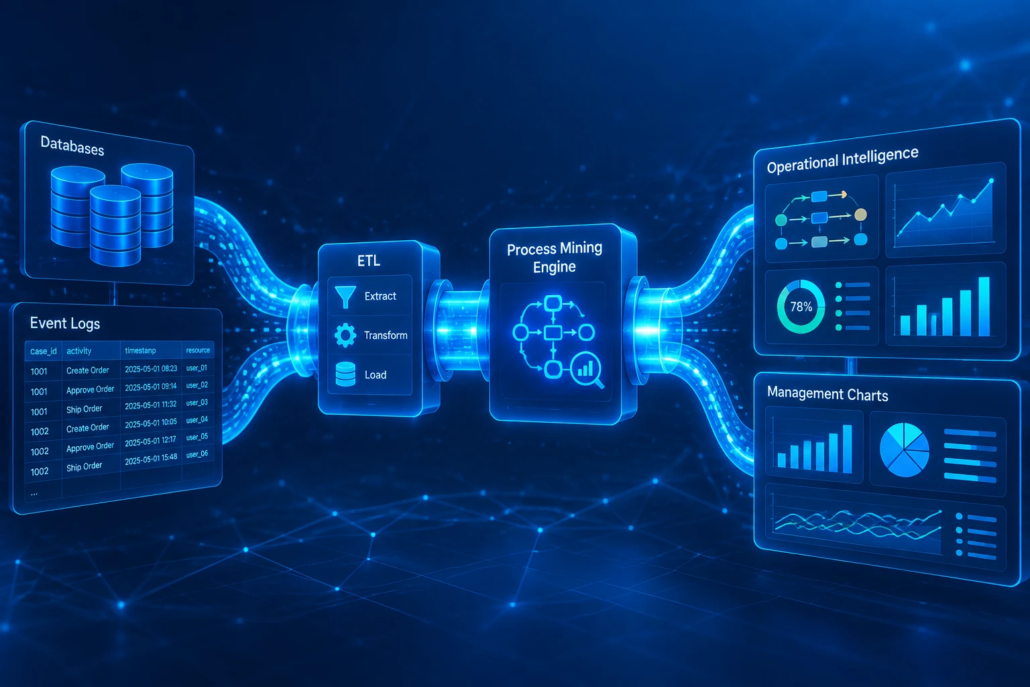
مسیر داده در فرآیندکاوی از لاگ رویداد و پایگاه داده تا هوش عملیاتی

در دنیای مدرن مدیریت، سازمان‌ها هزینه‌های هنگفتی صرف استقرار سامانه‌های ERP، CRM، پورتال‌های مشتریان و سیستم‌های اتوماسیون اداری می‌کنند. این سامانه‌ها هر ثانیه هزاران سطر لاگ تازه در پایگاه‌های داده ثبت می‌کنند. بااین‌حال، مدیران ارشد در جلسات هیئت‌مدیره و کارگروه‌های بهبود عملکرد هنوز با یک پرسش تکراری روبه‌رو هستند: «ما دقیقاً نمی‌دانیم در لایه عملیات چه می‌گذرد و چرا پروژه‌ها یا درخواست‌ها تأخیر دارند.»

ابزارهای سنتی نمی‌توانند رفتار پویای فرآیندها را به‌درستی مدل‌سازی کنند و همین محدودیت این شکاف را پدید می‌آورد. «فرآیندکاوی» (Process Mining) برای پاسخ به این چالش شکل گرفت؛ رویکردی که علم داده (Data Science) را با مدیریت فرآیندهای کسب‌وکار (BPM) پیوند می‌دهد. در این مقاله، مسیر گام‌به‌گام و فنی تبدیل رخدادهای خام سیستم به تصمیم‌های راهبردی مدیریتی را بررسی می‌کنیم.

پارادوکس داده‌ها؛ انباشت میلیاردها رکورد و استیصال در تصمیم‌گیری

سازمان‌ها معمولاً غرق در داده‌اند، اما برای دست‌یابی به اطلاعات معنادار تلاش می‌کنند. ابزارهای هوش تجاری سنتی (BI) داشبوردهایی جذاب و مبتنی بر ارقام تجمعی ارائه می‌دهند؛ برای مثال، اعلام می‌کنند «میانگین زمان رسیدگی به تیکت‌ها ۴ روز است» یا «نرخ بازگشت سفارش‌ها به ۱۰ درصد رسیده است». بااین‌حال، BI سنتی در یک نقطه بنیادین متوقف می‌شود: این ابزار نمی‌تواند چرایی و چگونگی جریان کار را در طول زمان نشان دهد.

تفاوت بنیادین BI سنتی با فرآیندکاوی؛ رویکرد وضعیت‌محور در برابر فرآیندمحور

ابزارهای BI سنتی رویکردی داده‌محور و ایستا (State-Oriented) دارند؛ یعنی وضعیت جاری جداول پایگاه داده را گزارش می‌کنند. در مقابل، فرآیندکاوی رویکردی فرآیندمحور (Process-Oriented) و مبتنی بر شواهد زمانی دارد. فرآیندکاوی به شما نشان می‌دهد که هر پرونده واحد، مانند سفارش، فاکتور، وام یا ادعا، چگونه میان واحدها، نقش‌ها و سامانه‌ها جابه‌جا شده است؛ در چه مراحلی توقف کرده و در کدام نقاط وارد چرخه بازکاری (Rework Loop) شده است.

معماری استخراج رخدادها؛ آناتومی یک لاگ فرآیندی (Event Log)

تمام الگوریتم‌ها و قابلیت‌های تحلیلی فرآیندکاوی به یک ساختار ورودی مشخص نیاز دارند: لاگ رخداد (Event Log). بدون لاگ استاندارد، سازمان نمی‌تواند هوش عملیاتی ایجاد کند. هر رخداد، روایتی عینی از یک فعالیت درون سیستم ارائه می‌دهد.

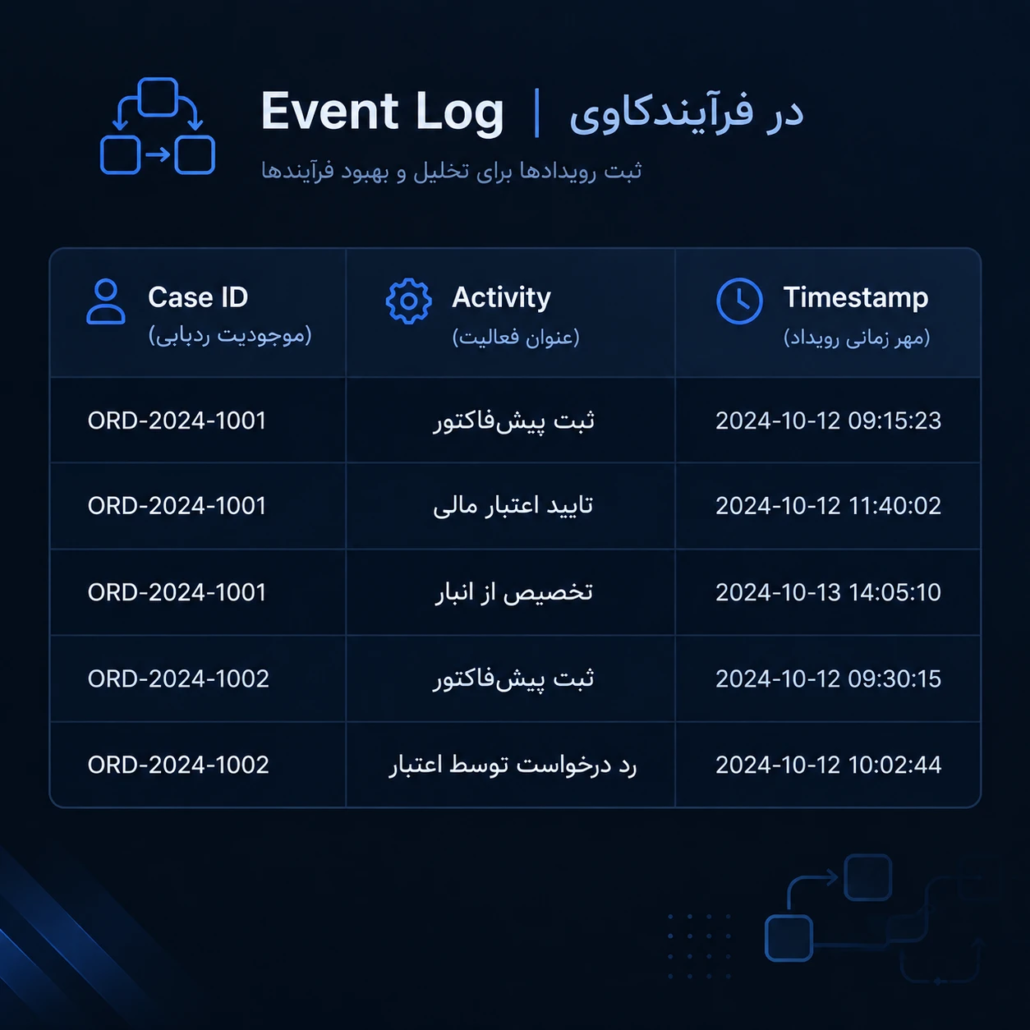
نمونه جدول ساختار داده و لاگ رویداد (Event Log) شامل Case ID، Activity و Timestamp در فرآیندکاوی

شکل ۱: ساختار حداقلی و استاندارد لاگ رویداد (Event Log) جهت پردازش در الگوریتم‌های فرآیندکاوی

سه‌گانه طلایی دیتالاگ: Case ID، Activity و Timestamp

برای استفاده از داده‌های سامانه در موتورهای فرآیندکاوی، باید دست‌کم سه عنصر بنیادین را در آن‌ها داشته باشید:

  • شناسه پرونده (Case ID): شناسه‌ای یکتا که تمام رخدادهای یک چرخه کاری مستقل را به هم پیوند می‌دهد؛ مانند Order_ID در سفارش‌ها، Claim_ID در بیمه یا Ticket_ID در پشتیبانی.
  • عنوان فعالیت (Activity Name): نام دقیق عملیاتی که رخ داده است؛ مانند «بررسی مدارک»، «صدور حواله انبار» یا «ارسال پیامک تأیید».
  • مهر زمانی (Timestamp): تاریخ و زمان دقیق پایان فعالیت. در سناریوهای ایده‌آل، زمان آغاز و پایان (Start/Complete) را نیز ثبت کنید و زمان را تا سطح میلی‌ثانیه نگه دارید تا صف انتظار را دقیق‌تر محاسبه کنید.

لایه ویژگی‌های تکمیلی (Attributes)؛ بستر تحلیل چندبعدی هزینه و منابع

ویژگی‌های تکمیلی، قدرت تحلیل چندوجهی را در اختیار تحلیل‌گر قرار می‌دهند:

  • عامل یا منبع (Resource/Actor): کاربر یا وب‌سرویسی که فعالیت را ثبت کرده است. تحلیل‌گر با این داده می‌تواند ماتریس تعاملات سازمانی و تحلیل شبکه اجتماعی (Social Network Analysis) را بررسی کند.
  • داده‌های هزینه و مالی (Cost Attributes): هزینه اختصاص‌یافته به هر گام را ثبت کنید تا بتوانید هزینه هدررفت فرآیندی را محاسبه کنید.
  • داده‌های طبقه‌بندی (Categorical Context): کانال ورودی مشتری، نوع محصول، موقعیت جغرافیایی و شعبه صادرکننده را به‌عنوان ویژگی‌های زمینه‌ای نگه دارید.

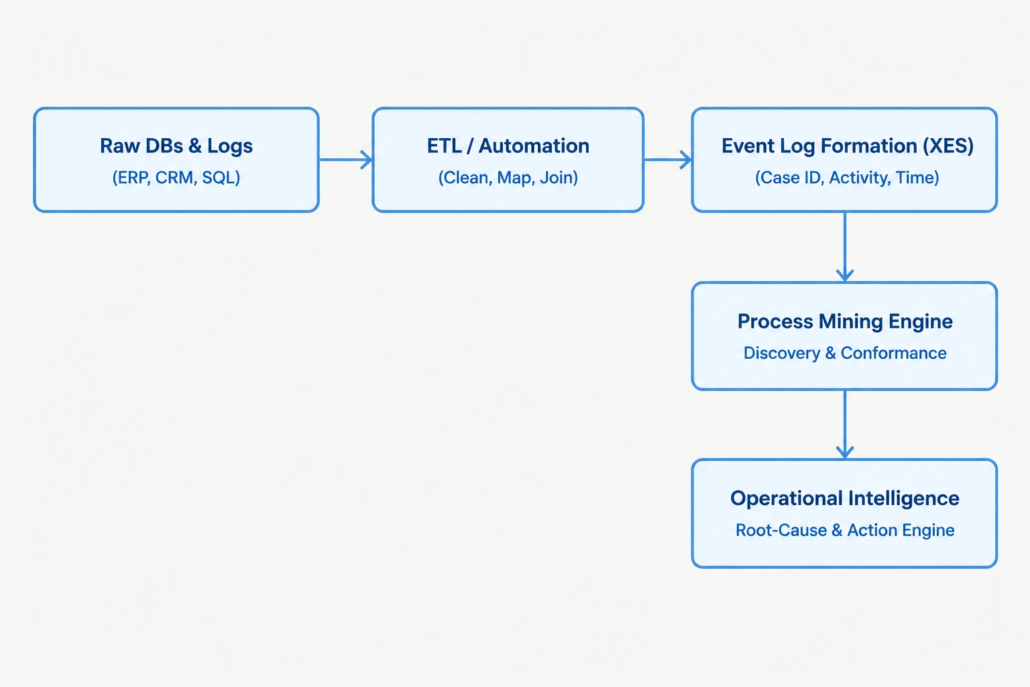
خط لوله مهندسی داده (Data Pipeline) در فرآیندکاوی

داده‌های سیستمی معمولاً به‌شکل تمیز و آماده به دست تحلیل‌گر نمی‌رسند. تیم پروژه بخش بزرگی از زمان خود را صرف ایجاد خط لوله انتقال و پالایش داده می‌کند؛ در بسیاری از پروژه‌های عملیاتی، این سهم به ۸۰ درصد می‌رسد.

مراحل <yoastmark class=

گام اول: تجمیع و اتصال به پایگاه‌های داده (Data Extraction & Ingestion)

در سامانه‌های واقعی، اطلاعات یک فرآیند میان چند پایگاه داده و جدول پراکنده است. برای مثال، تیم مالی ممکن است جدول تراکنش‌های پرداخت را در یک سرور نگه دارد و تیم انبارداری، جدول تخصیص بار را در سامانه‌ای دیگر. تیم فنی با خطوط لوله ETL یا پلتفرم‌های هماهنگ‌سازی جریان داده (Data Orchestration) این منابع را به هم متصل می‌کند و تغییرات رخدادها را به‌طور پیوسته پایش می‌کند.

گام دوم: پالایش، ادغام رخدادها و پاکسازی نویزها (Data Wrangling)

در این مرحله، تیم داده باید چند مسئله پیچیده را حل کند:

  • مدیریت ناهماهنگی در Timestamp: مغایرت ساعت سرورهای مختلف را برطرف کند، تفاوت منطقه‌های زمانی (Timezone) را در نظر بگیرد و تاریخ‌های ثبت‌شده با تأخیر را اصلاح یا مشخص کند.
  • ادغام لاگ‌های سطح پایین (Low-Level Events): رویدادهای کلیک سامانه را به فعالیت‌های مفهومی کسب‌وکار تبدیل کند؛ برای مثال، پنج کلیک برای تغییر فیلدها را در یک فعالیت با عنوان «ویرایش اطلاعات تماس» تجمیع کند.
  • مدیریت چرخه‌های ناقص: پرونده‌های ناتمام را از تحلیل چرخه‌های بسته‌شده جدا کند تا این پرونده‌ها شاخص زمان چرخه (Cycle Time) را منحرف نکنند.

گام سوم: تبدیل به فرمت‌های استاندارد (XES و ساختارهای تحلیلی)

IEEE استاندارد XES (eXtensible Event Stream) را برای ذخیره‌سازی رخدادهای فرآیندی تعریف کرده است. تیم داده می‌تواند داده‌ها را در این فرمت یا ساختارهای تحلیلی معادل، مانند Parquet و پایگاه‌های داده ستونی، ذخیره کند. این ساختارها به موتورهای فرآیندکاوی مدرن، از جمله پلتفرم‌های ابری و موتورهای متن‌باز، کمک می‌کنند میلیون‌ها گره را با سرعت بالا پردازش کنند.

از کشف فرآیند تا تحلیل انطباق (Discovery to Conformance)

پس از آنکه تیم داده، دیتالاگ را در موتور پردازش بارگذاری کرد، دو فاز تحلیلی کلیدی آغاز می‌شود.

کشف خودکار گراف فرآیند (Process Discovery)

الگوریتم‌های پیشرفته کشف فرآیند، مانند Inductive Miner و Heuristics Miner، توالی رخدادها را تحلیل می‌کنند و مدل واقعی فرآیند را ترسیم می‌کنند. این مدل با نقشه‌های ایده‌آلی که سازمان در دفترچه فرآیندهای خود نگه می‌دارد تفاوت دارد. خروجی واقعی معمولاً شبکه‌ای پیچیده از مسیرهای فرعی (Variations)، میان‌برهای غیرمجاز و چرخه‌های بازکاری بی‌پایان را نشان می‌دهد؛ الگویی که گاهی از آن با عنوان «فرآیند اسپاگتی» (Spaghetti Process) یاد می‌کنند.

انطباق‌سنجی (Conformance Checking)؛ تقابل واقعیت عملیاتی با مدل هدف

انطباق‌سنجی، فرآیندکاوی را به استانداردهای مدیریت کیفیت و مدل‌های مرجع، مانند BPMN 2.0 و چارچوب طبقه‌بندی فرآیندی APQC، پیوند می‌دهد. تحلیل‌گر مدل هدف طراحی‌شده (As-Designed) را با مدل واقعی استخراج‌شده از لاگ‌ها (As-Is) مقایسه می‌کند. این تحلیل موارد زیر را آشکار می‌کند:

  • فعالیت‌های حذف‌شده (Skipped Activities): مشخص می‌کند کدام پرونده‌ها گام‌های کنترلی یا تأییدهای اجباری را دور زده‌اند.
  • فعالیت‌های پیش‌بینی‌نشده (Unexpected Activities): فعالیت‌های غیررسمی سازمان را نشان می‌دهد؛ فعالیت‌هایی که در مستندات فرآیند جایی ندارند.
  • تغییر توالی (Out-of-Order Execution): مواردی را پیدا می‌کند که برای مثال، کارکنان کالا را پیش از صدور فاکتور رسمی از انبار خارج کرده‌اند.

لایه بلوغ تصمیم‌گیری؛ چگونه لاگ‌ها خروجی اقدام‌پذیر (Actionable) تولید می‌کنند؟

اگر سازمان داده را به تصمیم و اقدام تبدیل نکند، منابع محاسباتی و تحلیلی را هدر می‌دهد. مهندسی این مسیر باید تصمیم‌گیری را از «حدس و تجربه فردی» به «شواهد صریح سیستمی» ارتقا دهد.

تحلیل ریشه‌ای گلوگاه‌ها (Root-Cause Analysis)

فرض کنید فرآیندکاوی نشان می‌دهد که زمان انتظار میان «بررسی مدارک» و «تأیید نهایی» به‌جای ۲ ساعت، ۴۸ ساعت طول می‌کشد. تحلیل‌گر با بررسی ویژگی‌های رخداد (Attributes)، عوامل مؤثر بر تأخیر را شناسایی می‌کند. برای مثال، او درمی‌یابد که ۹۰ درصد پرونده‌های تأخیردار به یک شیفت کاری خاص، نوع مشخصی از درخواست یا شعبه‌ای معین تعلق دارند. این بینش، مدیران را از صدور دستورالعمل‌های مبهم و یکسان برای همه واحدها بازمی‌دارد و به آن‌ها امکان می‌دهد اصلاحات هدفمند انجام دهند.

فرآیندکاوی پیش‌بینانه و تجویزی (Predictive & Prescriptive Process Mining)

سازمان می‌تواند با افزودن هوش مصنوعی و مدل‌های یادگیری ماشین به خط لوله فرآیندکاوی، از تحلیل گذشته‌نگر به مدیریت بلادرنگ و آینده‌نگر حرکت کند:

  • پیش‌بینی تأخیر (Remaining Time Prediction): سیستم در همان گام‌های اولیه ثبت پرونده، الگوی رخدادها را بررسی می‌کند و هشدار می‌دهد که پرونده با احتمال ۸۵٪ توافق‌نامه سطح خدمت (SLA) را نقض خواهد کرد.
  • اقدام تجویزی (Prescriptive Action): سازمان می‌تواند سامانه مدیریت کار را طوری تنظیم کند که پرونده را خودکار در اولویت قرار دهد یا آن را به کارشناس پشتیبان دیگری بسپارد.

دام‌ها و چالش‌های پیاده‌سازی مسیر داده در سازمان‌های ایرانی

پیاده‌سازی موفق این معماری در سازمان‌های ایرانی به عبور از چند چالش رایج نیاز دارد:

  • فقدان تفکر ساختاریافته فرآیندی: اگر تحلیل‌گران با استانداردهای تحلیل کسب‌وکار (BABOK) آشنا نباشند یا معماری فرآیندی APQC را درک نکنند، پروژه ممکن است به بن‌بست فنی برسد.
  • کیفیت پایین لاگ‌گذاری (Logging Culture): بسیاری از سامانه‌های داخلی، لاگ‌ها را فقط برای خطایابی فنی (Error Log) ثبت می‌کنند و رویدادهای کسب‌وکاری (Business Events) را در نظر نمی‌گیرند.
  • مقاومت سازمانی در برابر شفافیت عملیاتی: فرآیندکاوی به سادگی می‌تواند کم‌کاری‌ها، دور زدن رویه‌ها و ناکارآمدی‌های فردی و ساختاری را عیان سازد؛ به همین دلیل، سازمان‌ها باید مدیریت تغییر را همپای مهندسی داده در موفقیت پروژه جدی بگیرند.

جمع‌بندی راهبردی؛ فرآیندکاوی به‌مثابه سیستم عصبی کسب‌وکار

خط لوله فرآیندکاوی، رخدادهای خام پایگاه‌های داده را از معماری چندلایه عبور می‌دهد و به هوش عملیاتی تبدیل می‌کند. با ایجاد این خط لوله، مدیران ارشد دیگر به حدس و گمان در جلسات ماهانه تکیه نمی‌کنند. در عوض، سازمان می‌تواند به سیستم عصبی زنده‌ای مجهز شود که انحراف از استاندارد، گلوگاه پنهان و اتلاف منابع را به‌موقع گزارش می‌دهد و زمینه تصمیم‌گیری راهبردی مبتنی بر شواهد را فراهم می‌کند.

0 پاسخ

دیدگاه خود را ثبت کنید

تمایل دارید در گفتگوها شرکت کنید؟
در گفتگو ها شرکت کنید.

دیدگاهتان را بنویسید

سوال بپرسید
فعال سازی اعلان ها تایید نه متشکرم